这是一次组会的邮件汇报文档,这里做一下存档。
这篇论文是发布在 NeurIPS2026 上的文章,题目是 TF-PRVR: Training-Free Partially Relevant Video Retrieval。
该论文在 PRVR 领域首次引入 Training-Free 范式,为该领域提供了一种无需训练模型的新思路。
首先是动机部分。
1. 动机
 图片加载中…图片加载失败
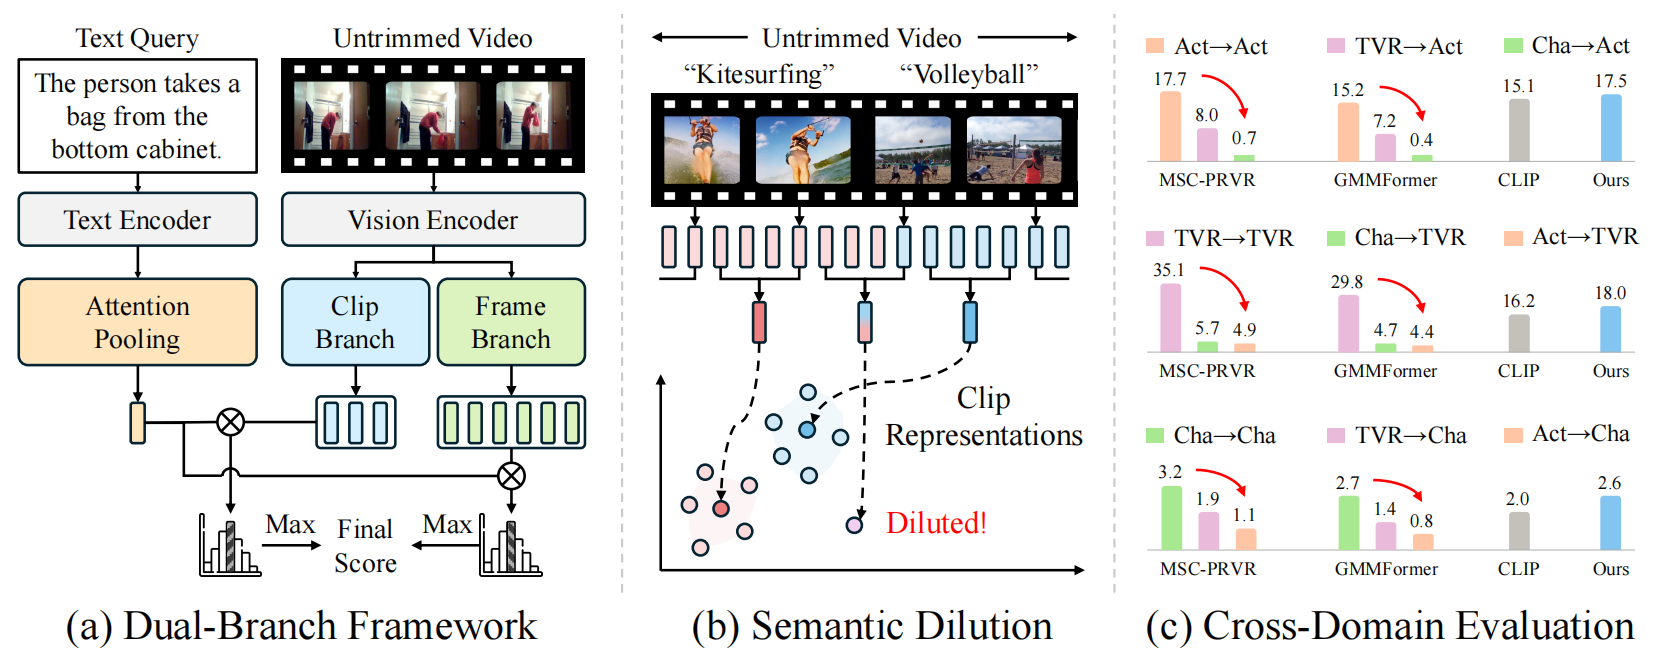
第一张图是总的研究动机图,如上,子图(a)展示的是当前的 PRVR 通用的双分支检索框架。
论文认为,这样的框架存在着一些问题。主要体现在 Clip Branch 里。
如子图(b)所示,在 Clip Branch 中,先前的研究工作主要通过将视频帧均匀划分为若干片段,并对各片段内的帧级特征进行平均池化来获得片段级特征。论文认为,这样做会存在如下问题(前两个动机):
- 对于视频中持续时间较长的事件,均匀划分策略可能将同一完整事件分割到不同的视频片段中,破坏事件在时间维度上的完整性,导致片段级特征难以充分保留事件的整体语义信息。
- 对于视频中持续时间较短的事件,均匀划分策略可能导致该事件与其他事件被划分至同一视频片段,使片段级特征混合不同事件的语义信息,从而降低特征的语义纯度与判别能力。
而不同数据集中的事件分布及时间跨度往往存在差异,采用固定的均匀划分策略难以适应不同数据集的时序特征,可能导致模型对特定数据集的事件分布产生过度依赖,进而影响其泛化能力。
如子图(c)所示,图中的 数据集 A→数据集 B 表示使用数据集 A 的训练集进行训练,在数据集 B 的测试集上进行推理评估测试。可以看到,当前一些 SoTA 方法,如 MSC-PRVR 和 GMMFormer,都出现了前面所分析的问题,跨数据集泛化能力较差,且远远低于直接用 CLIP 进行零样本推理的结果。相比之下,这篇论文所提出的方法(蓝色柱状图),性能甚至超过了 CLIP。
 图片加载中…图片加载失败
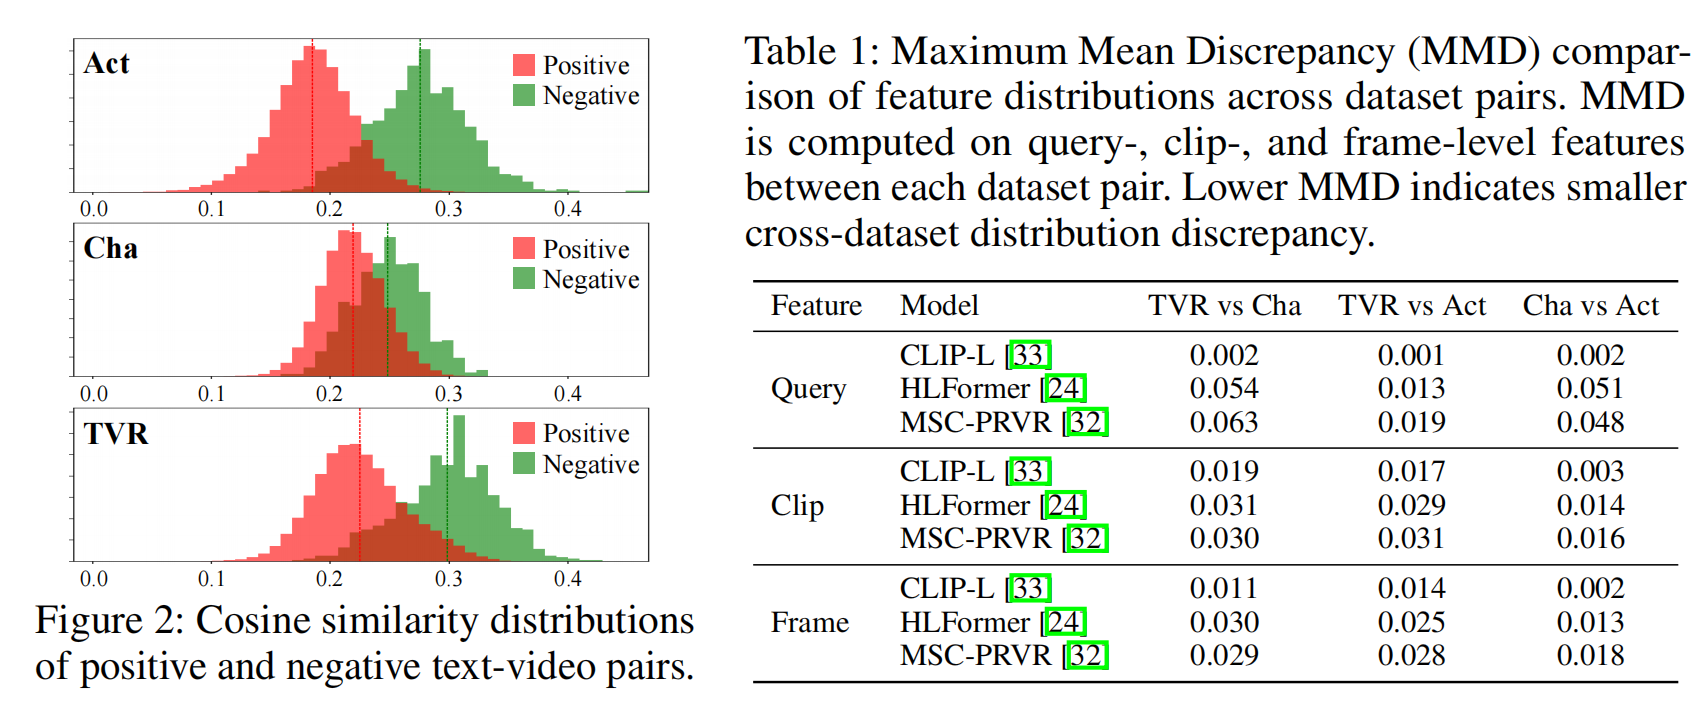
再看动机部分的第二张图和第一张表,如上。
图 2 展示了不同数据集中,正样本与负样本对的余弦相似度分布(图可能作者手误画错了,因为现在的图是负样本相似度反而要比正样本高,但是不影响动机的理解),可以看到不同的数据集下,正负样本余弦相似度分布的重合程度也不尽相同,重合的越多,说明数据集越困难,正负样本越难区分。
表 1 展示了当前部分 SoTA 方法与 CLIP 零样本推理所提取的特征在不同数据集之间的分布差异,并采用最大均值差异(MMD)对其进行量化评估。MMD 指标反应了不同数据集之间的分布差异,差异越大,指标越高。
从表 1 中不难看出,直接使用 CLIP-L 得到的特征,在任意两个数据集之间,MMD 几乎指标都很小。
反观另外两个 SoTA 的方法,任意两个数据集之间的 MMD 都相对较大。
总之,这个图和这个表主要想反应不同的数据集之间分布差异还是比较大的,从而呼应前面的动机。
 图片加载中…图片加载失败
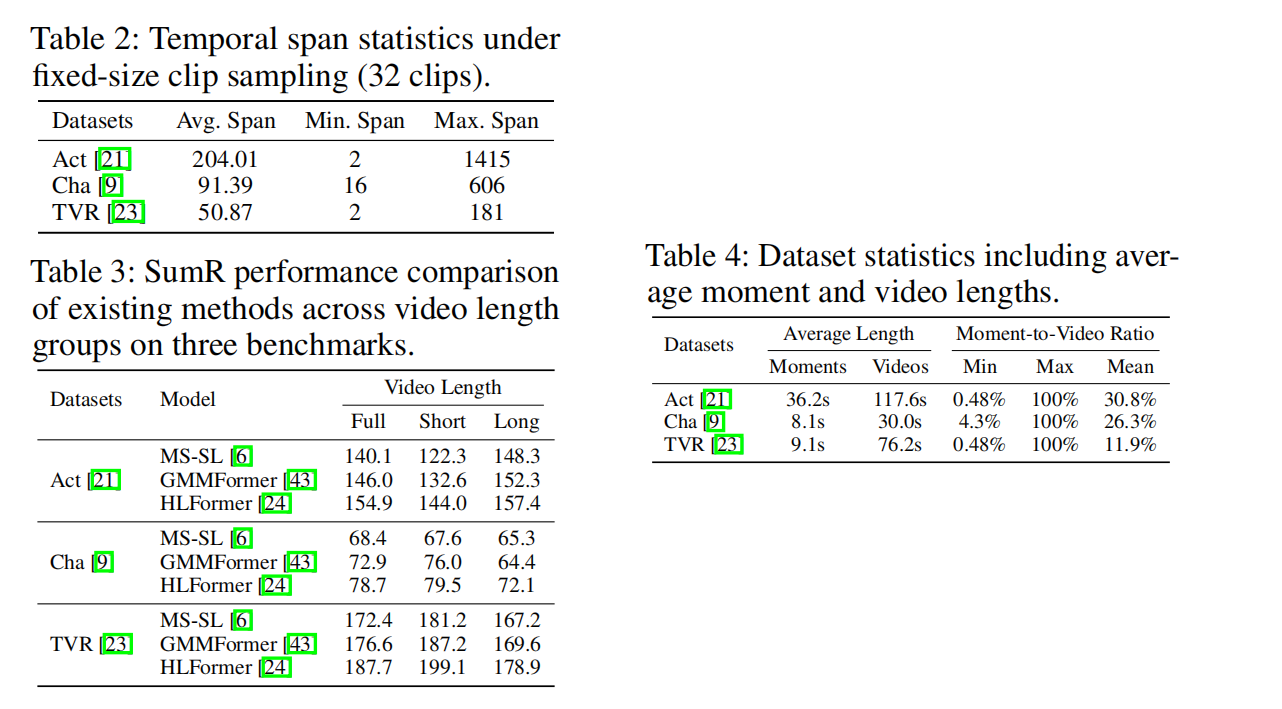
然后论文又展示了 3 个表格,表 2 展示了不同数据集下,采用固定的片段采样策略,即在每个数据集下,每个视频都均匀划分成 32 和片段,然后统计一下每个片段中所包含的帧的数量。可以看到,在表 2 中,不同的数据集帧跨度都不尽相同,比如 ActivityNet 数据集中主要以长视频为主,所以平均每个片段下有 204.01 个帧,而 TVR 数据集每个片段下只有 50.87 个帧。同时,即使是在同一个数据集内部,帧跨度的也有相当的差异。例如在 Charades STA 数据集下,最短的片段只有 16 个帧,最长的片段却有 606 个帧。
表 3 将每个数据集都划分成了两个子数据集,分别只包含较短的视频和较长的视频。然后使用部分 SoTA 方法对每个数据集的整集和子集进行推理评估。表 4 是对不同数据集下视频的总时长和正确片段总时长的时间的统计。
从两个表可以发现,ActivityNet 数据集的动作片段相对较长,占比达 30.8%,如果采用现有的“一刀切”固定分段策略,短视频里的长动作就会被切碎破坏完整性,所以现有方法在长视频上得分反而更高。但 TVR 数据集的目标动作极短,占比仅 11.9%,如果面对长视频还要去强行等分,切出来的片段势必会混入大量无关背景,造成严重的“语义稀释”,因此模型在它的短视频上表现反而更好。这两张表用最直观的数据狠狠戳中了现有固定切分策略过于死板的痛点,再次呼应了动机。
 图片加载中…图片加载失败
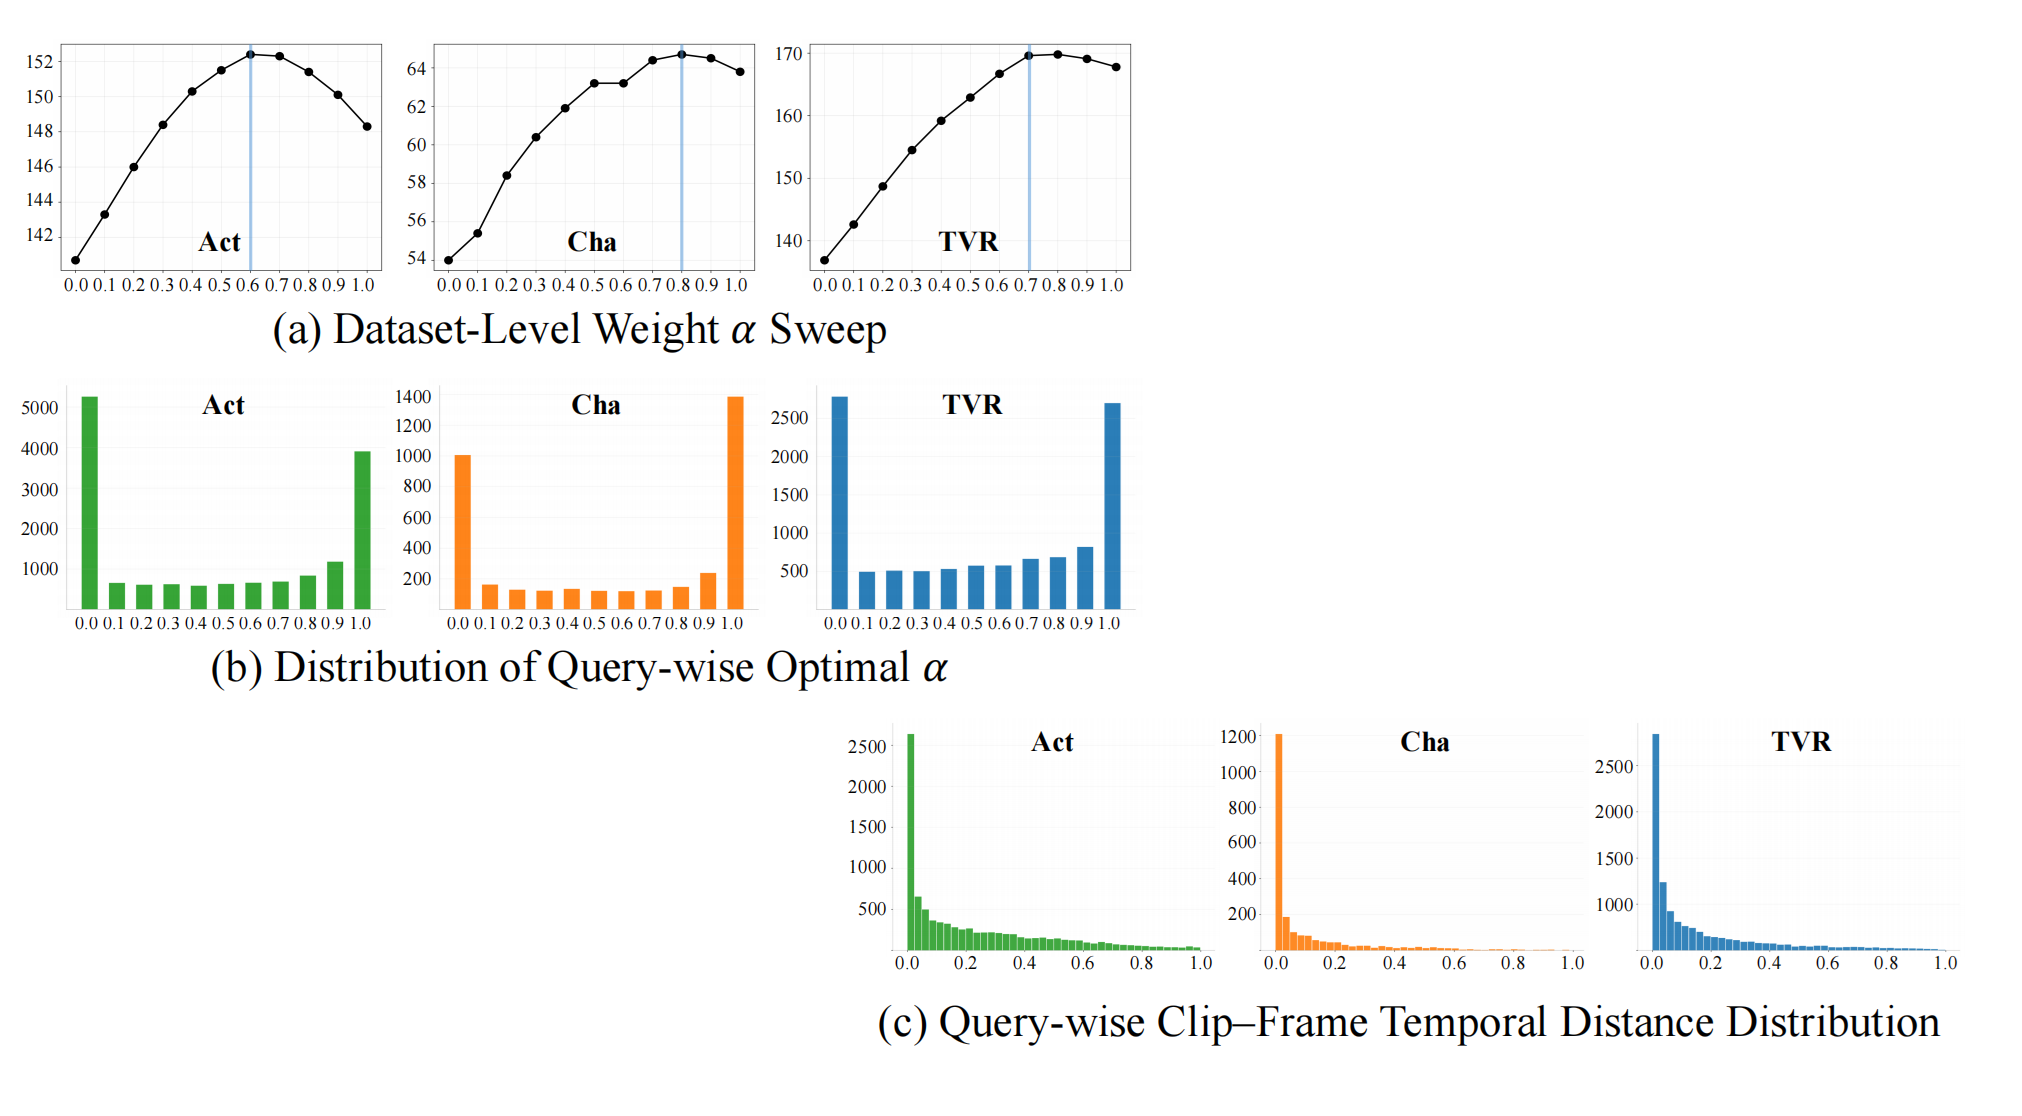
动机的最后部分,论文又做了三个图表,子图 a 和 b 横坐标表示的都是双分支的融合权重,子图(a)的纵坐标表示模型性能。可以看到不同的数据集最优的融合权重一般是不同的。
子图(b)的纵坐标表示有多少个文本查询找到了正确的视频,可以发现,两极分化严重,说明有部分文本就是比较依赖于帧级特征中的静态语义信息,有部分文本比较依赖片段级特征中的动态语义信息,很少的文本同时需要依赖这两类分支的特征。
子图(c)的横坐标是某个文本检索到两个分支的最高相似度的特征,所对应的时刻距离的归一化数值,纵坐标是检索正确的文本的数量。从图中明显的长尾分布可以看出,这两个分支挑出来的特征在时间上经常严重错位(这是第三个动机),根本没有对齐到同一个事件上。这彻底暴露了现有框架独立聚合会导致严重的时序不一致问题,非常自然地为作者后文提出用统一图结构来约束一致性做足了铺垫。
2. 方法
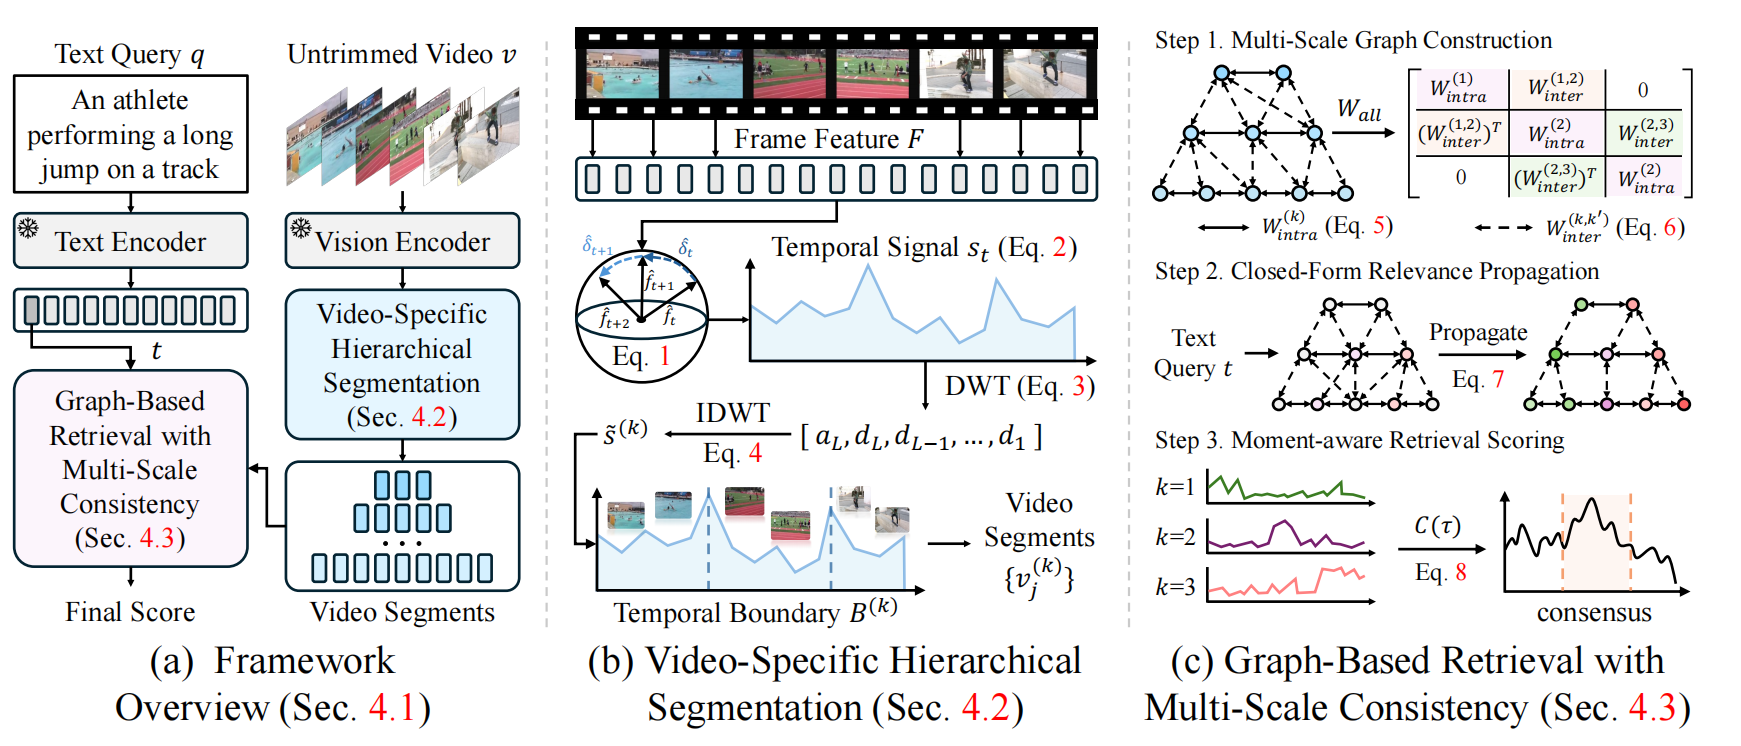
然后是方法部分,整体框架图如下所示:
 图片加载中…图片加载失败
总体框架如子图(a)所示,首先通过冻结的 clip 编码器获得文本和视频的特征,然后视频的特征进入论文设计的一个层次化分割模块(子图(b)所示),然后切割出来多个层次的片段级别的特征,然后将文本特征和切割后的片段级别的特征,送入论文设计的基于图的多尺度共识检索模块(子图(c)所示),获得最终的检索分数。
这两个模块的具体细节如下所示。
首先是层次化分割模块:
 图片加载中…图片加载失败
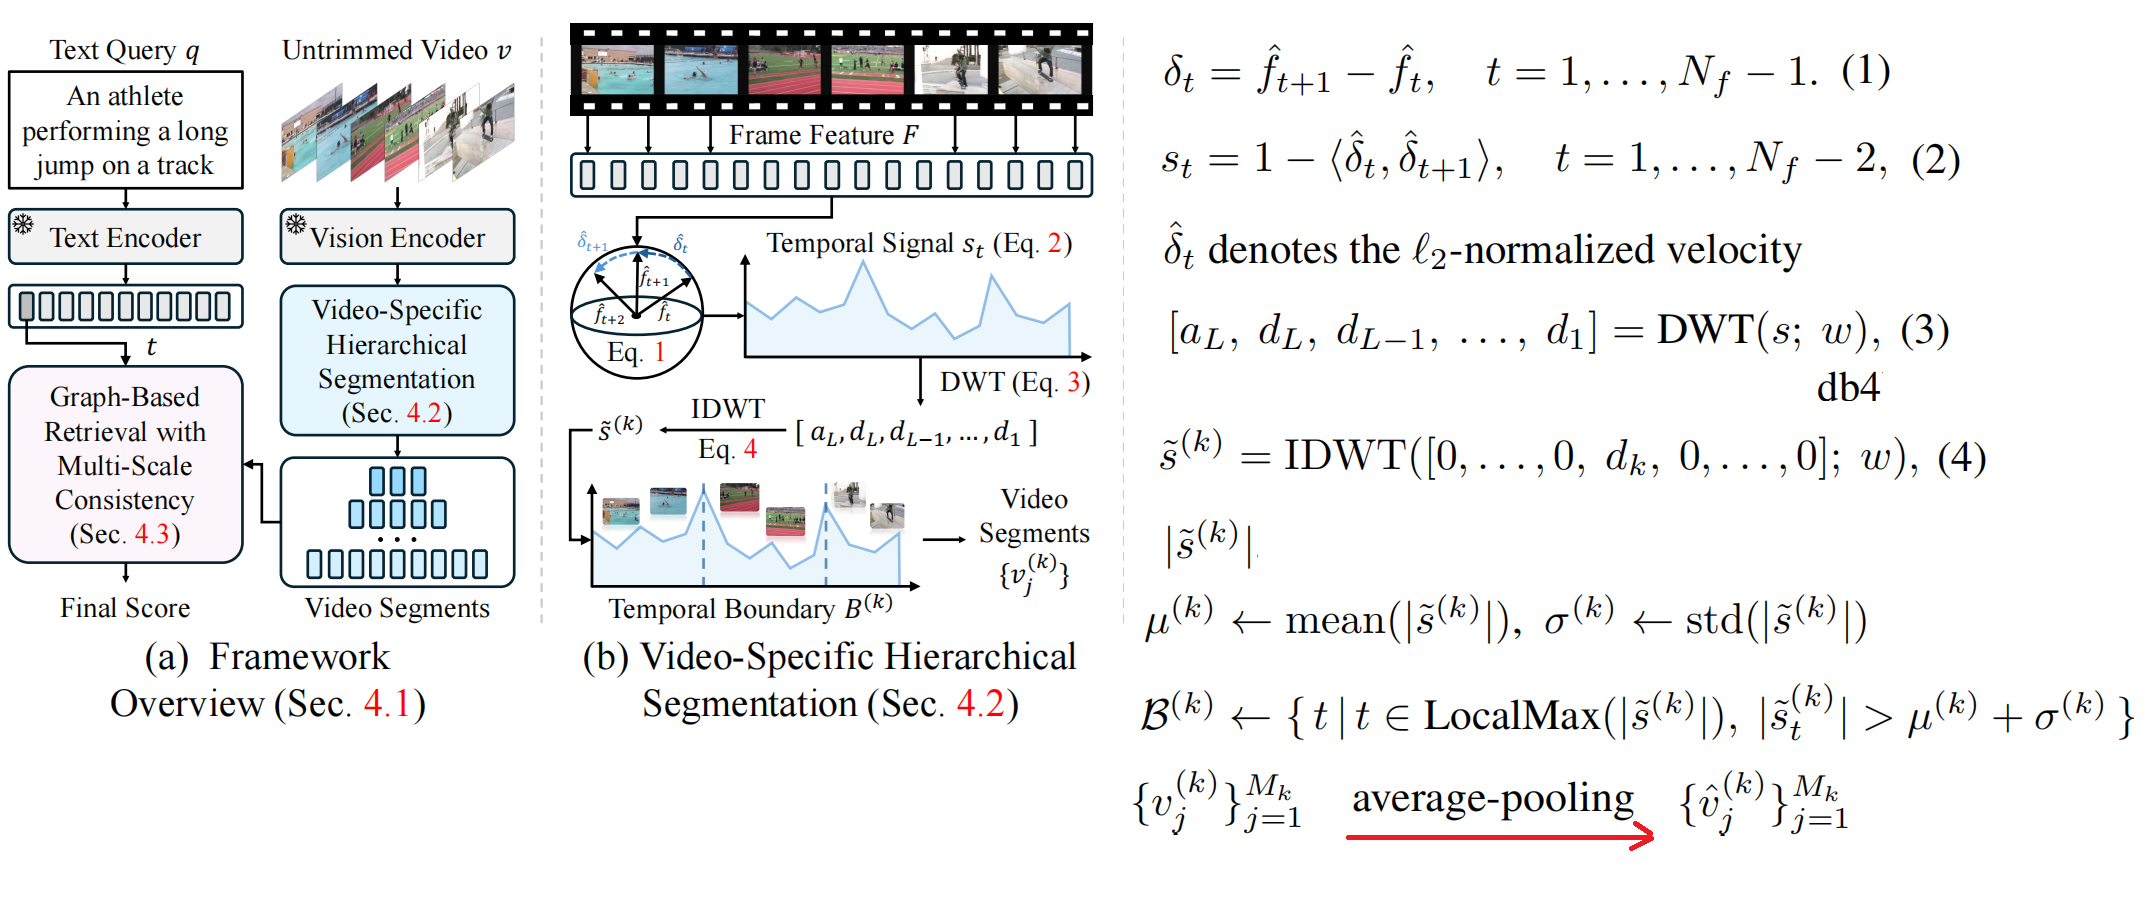
如上图所示,具体来说就是先按照公式 1 计算相邻帧级特征之间的速度变化特征, 表示视频帧特征, 表示速度变化特征,加 \hat 的表示归一化特征。
首先按照公式 1 计算出两两相邻特征的速度变化特征,然后根据公式 2 计算这些相邻的速度变化特征的不相似度。理论上不相似度越高,越可能是不同事件的交界处。
将处理出来的不相似度按照时间顺序排列成时间信号序列 。
然后论文根据公式 3,进行小波变换,使用 db4 小波基,将 分解为多个不同频率层次的信号序列。其中 是低频信息,反应了全局变化趋势, 表示是不同频率层次的高频信息, 越小,频率越高,对局部变化的关注度更强。
拿到这些多尺度信号后,紧接着看公式 4,论文对每个层级的细节系数单独做逆小波变换还原成当前尺度下的时序响应曲线,并直接去找曲线上的局部极大值点(逆小波变换结果先取绝对值,然后结合序列均值与方差确定),这些点就顺理成章地成了视频在不同时间粒度下的“天然分割边界”。通过这套操作,论文彻底摆脱了此前死板的定长切分,完全让视频自身的语义内容来决定该在哪儿划清界限,漂亮地完成了自适应的层次化视频分割。
假设当前第 个序列层次产生的结果,让视频分割成了 组片段,那么每个片段里面的帧级特征进行平均池化,就得到了片段级别的特征。
获得片段级别特征后,紧接着就是基于图的多尺度共识检索模块,如下所示:
 图片加载中…图片加载失败
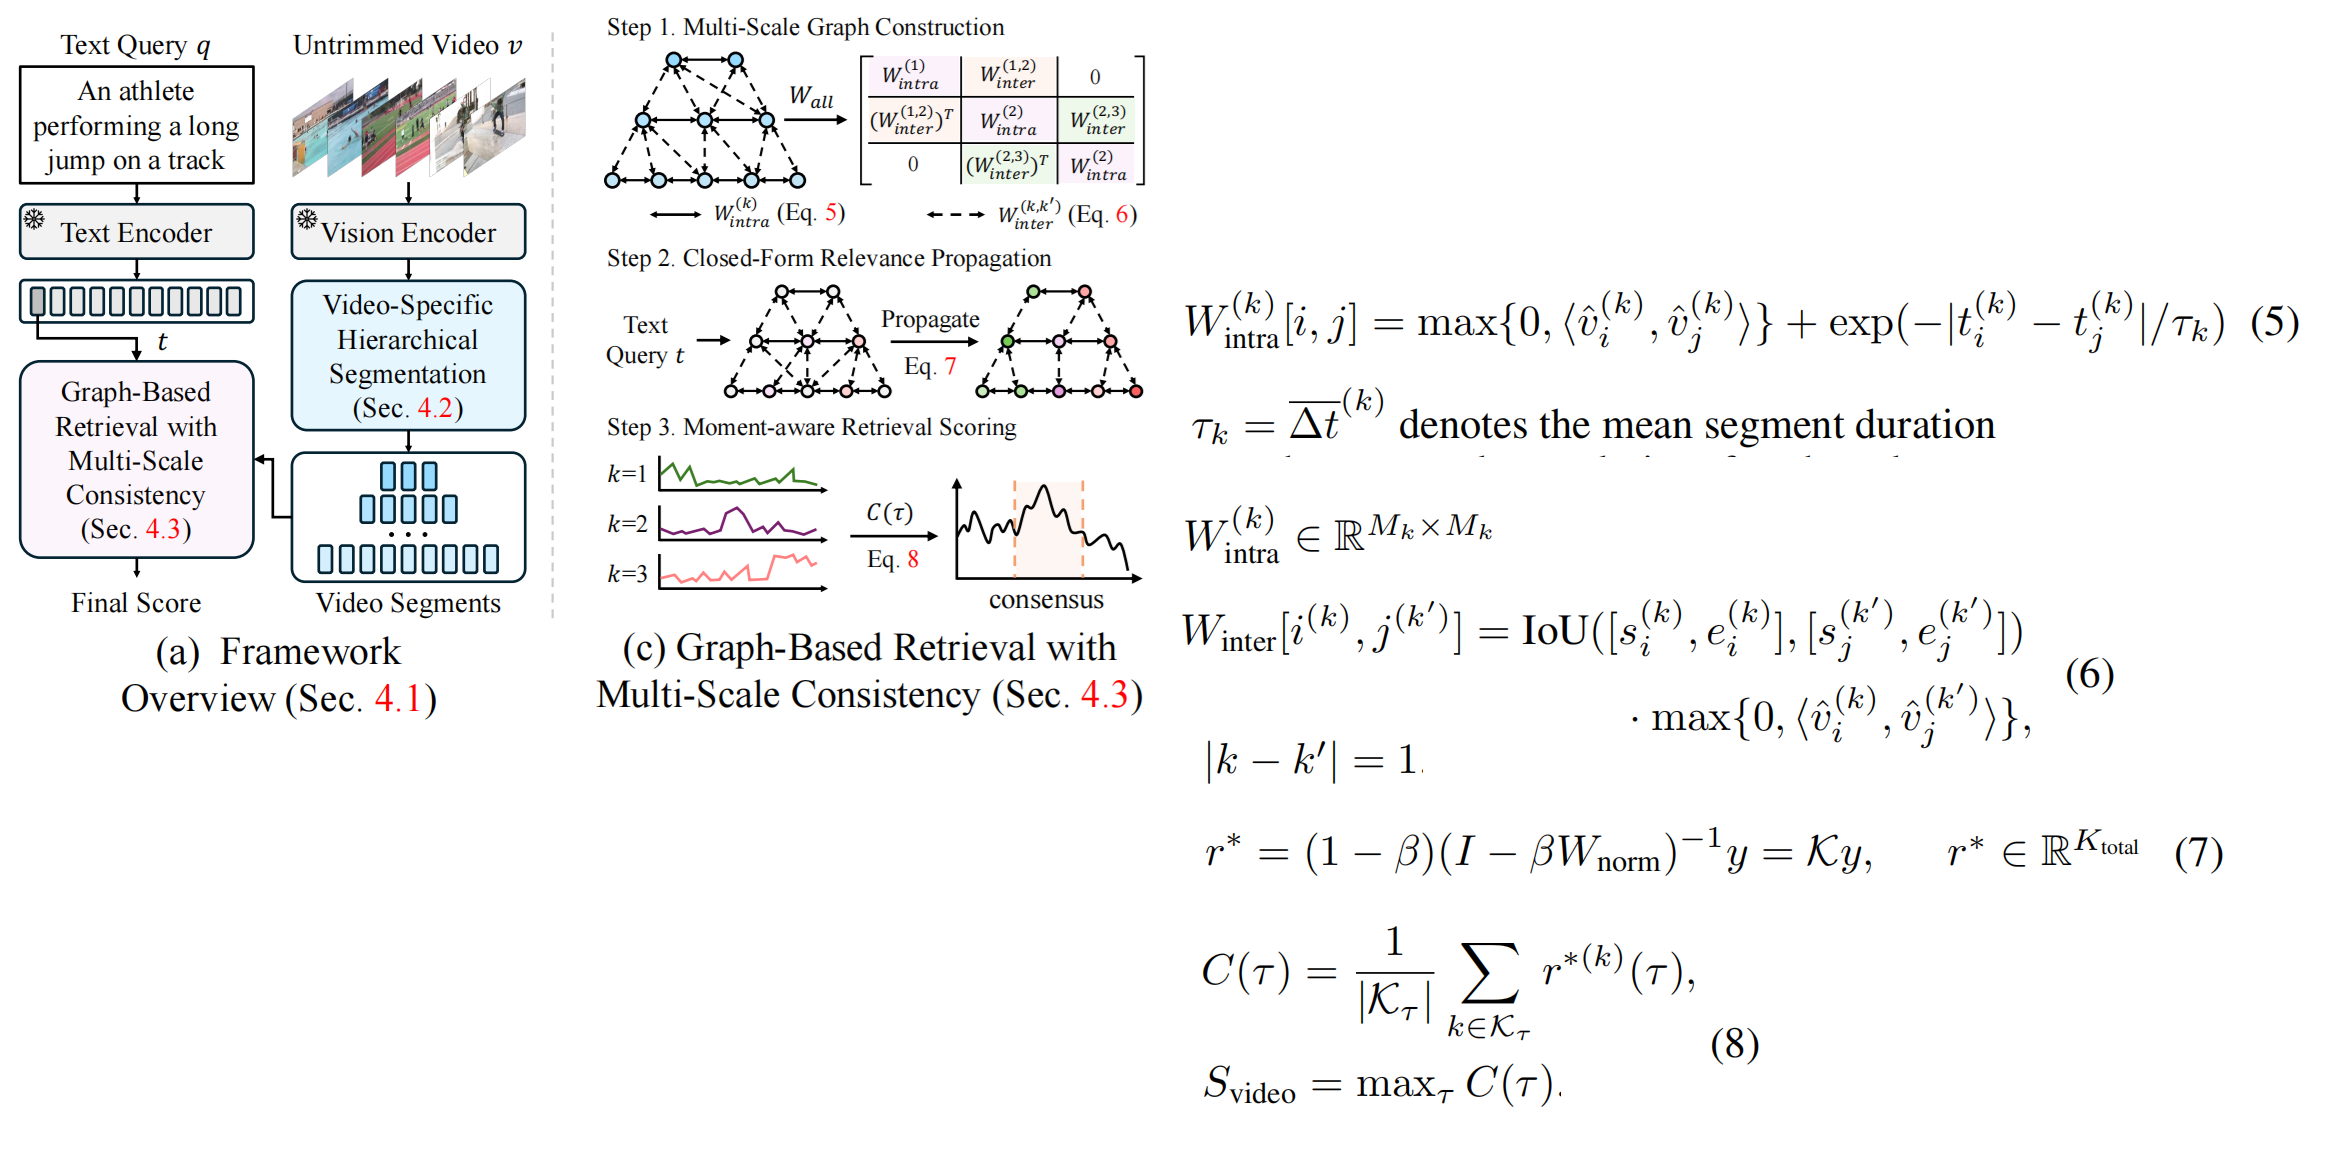
具体来说,论文把这些切分好的片段特征当成图的节点,巧妙地构建了一个统一的多尺度图结构。
图里的连边主要分为两类:一种是同层级内部的连边(对应公式 5),它既考量两个片段特征的视觉余弦相似度,又通过指数衰减来约束它们在时间轴上离得近不近;另一种是跨层级的连边(对应公式 6),主要把相邻尺度下在时间上有重叠(即计算 IoU)且语义相似的片段连起来。把这两类关系拼到一起并做对称归一化,就得到了一张能够统筹全局时空关系的图邻接矩阵。
建好图之后,文本查询就正式进场了。首先算一把文本特征和各个片段特征的初始相似度,然后为了解决动机部分最后提到的“时序错位”这个痛点,论文根据公式 7 设计了一个基于闭式解的相关性传播机制。这波操作非常优雅,因为它不需要任何训练,直接通过矩阵乘法,就能让初始的相似度分数顺着图结构在各个片段节点之间“流动”起来。这样一来,时间上连贯、语义上相关的多尺度片段就能互相“打气”增强,强制拉齐了特征在多尺度下的时序一致性。 其中 参数表示当前某个结点的特征要融合多少比例的邻居结点的特征。 表示图结点的总数。
最后就是时刻感知打分环节(对应公式 8)。论文在整段视频的时间轴上拉了一张密集的时间网格。对于网格上的每一个时间点,系统会把覆盖该时间点()的所有层级片段传播后的分数求个平均,算出这个时刻的“共识得分”。最后,取整段视频里共识得分最高的值作为最终的检索分数。这样做的好处非常明显:它能狠狠打压那些只是碰巧在单一尺度里得分偏高、但缺乏全局共识支撑的“孤立假阳性”片段,让真正稳定和多尺度一致的正确事件脱颖而出。
3. 实验
然后是实验部分:
 图片加载中…图片加载失败
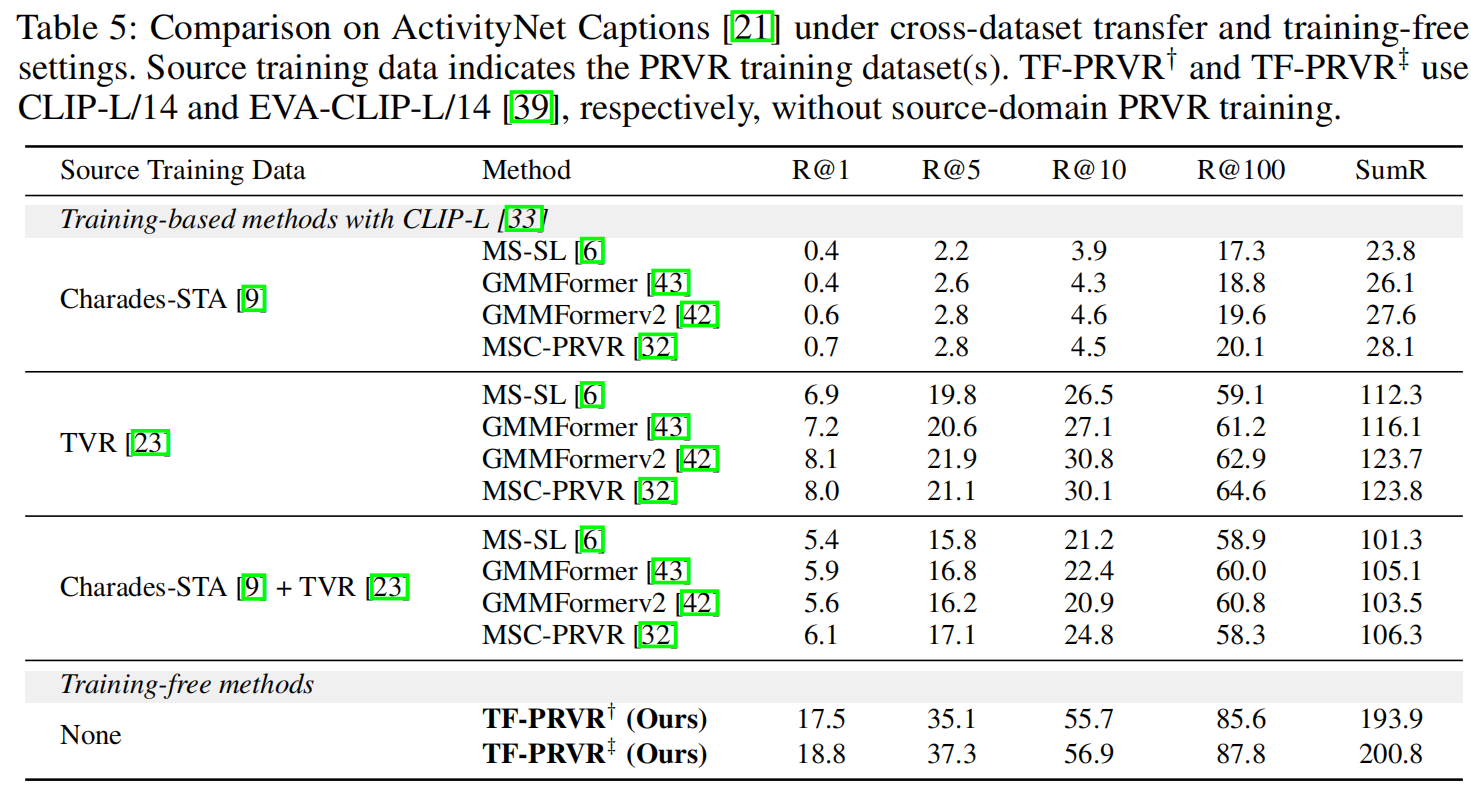
这个图展示了当前的 SoTA 方法在 ActivityNet Captions 上的检索结果,可以发现,论文提出的方法效果整体最优。
 图片加载中…图片加载失败
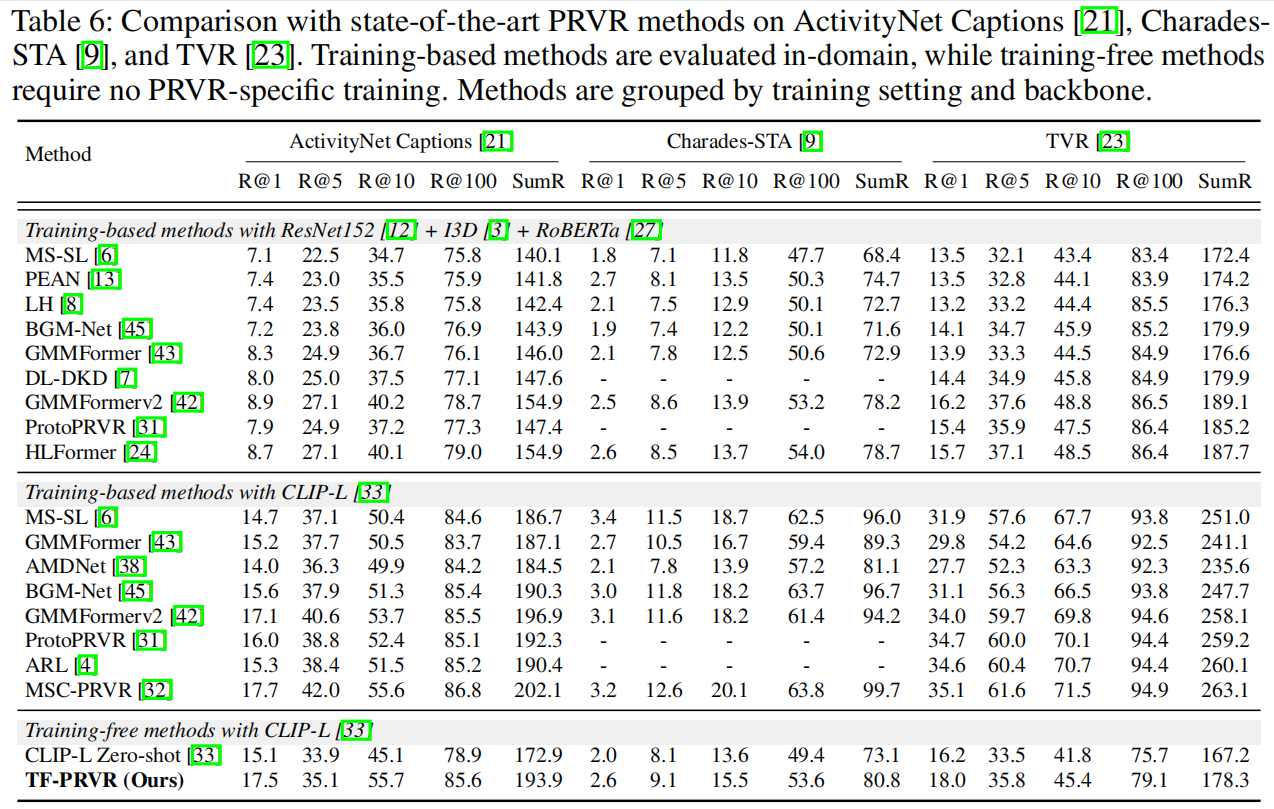
这个图是论文的方法在三个数据集上的主性能表格,可以看到,结果比 CLIP-L 的零样本推理的结果要好很多。
 图片加载中…图片加载失败
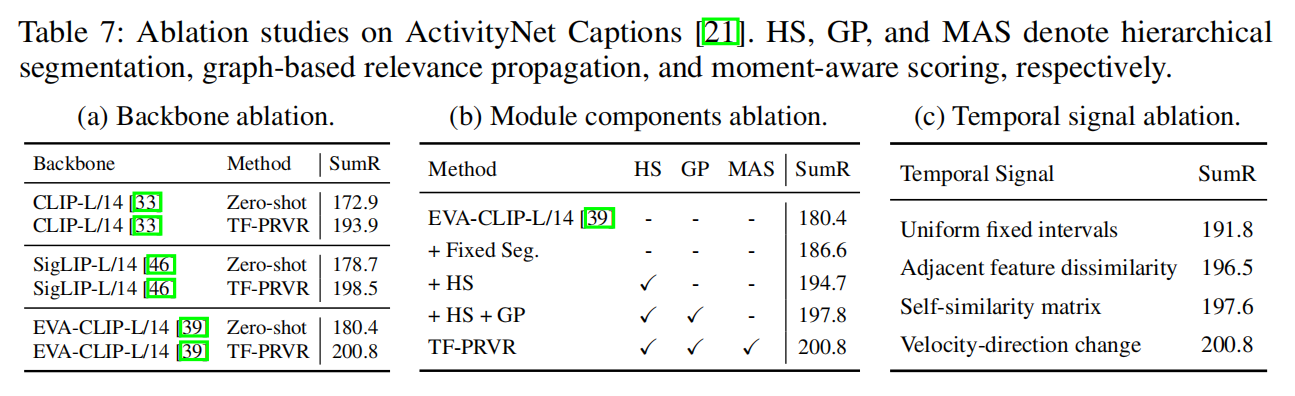
这个图是消融实验,子表(a)是展示不同骨架的消融。
子表(b)中 HS 表示前面的多层次切割模块,GP 表示建图的那个模块,MAS 是哪个共识得分模块。
子表(c)展示了不同的不相似度信号序列构建依据的消融:第一行是固定的均匀切割,第二行是直接根据相邻的帧级特征的不相似度构建,第三行是根据自相似度矩阵构建,第四个是论文提出的速度方向变化特征构建。
总体来看,都是论文的默认实验配置更好。
 图片加载中…图片加载失败
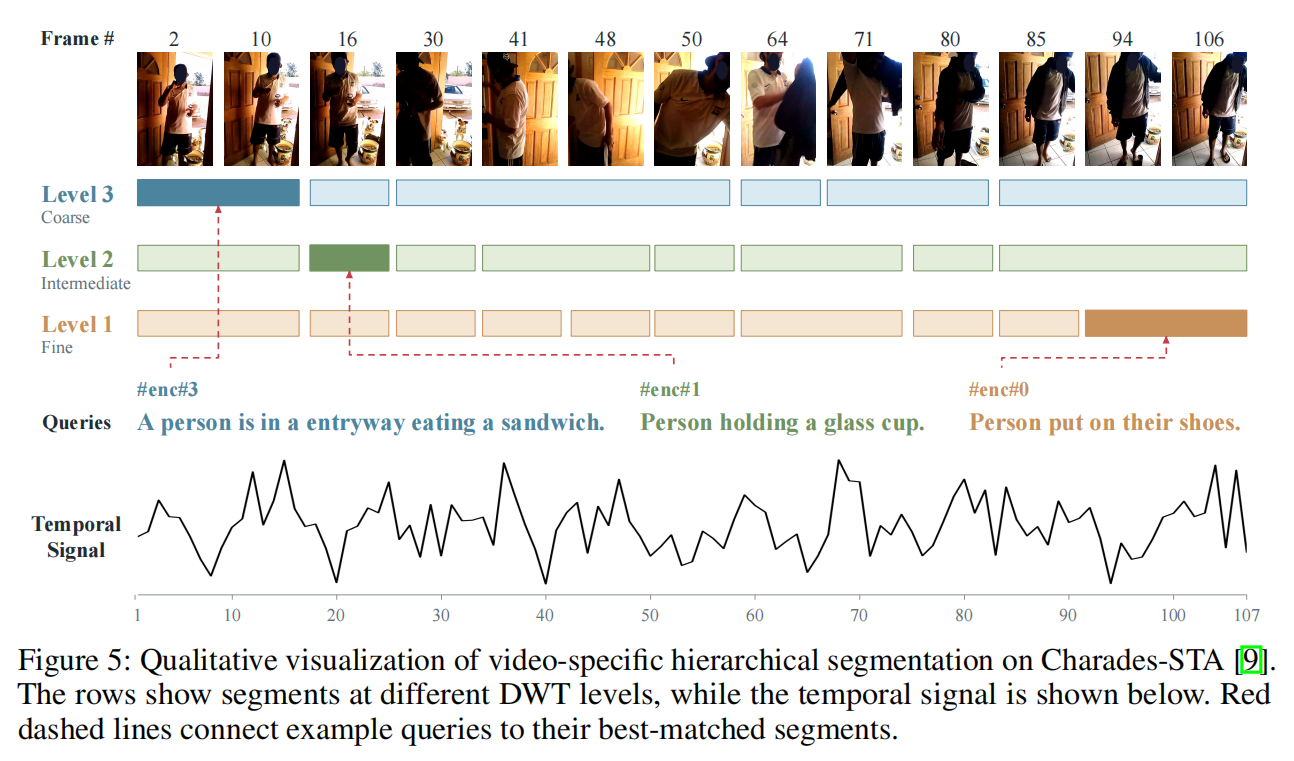
这个图是一个可视化,可以看到不同长度的文本几乎都能从多层次的切割结果中,找到比较纯净的事件片段。
4. 总结
总之,论文提出了首个 Training-Free 的 PRVR 框架,巧妙地利用小波变换让视频根据自身语义内容实现自适应的层次化切分,解决了死板等分带来的语义稀释痛点。同时,该框架通过构建多尺度图结构和分数传播机制,强制拉齐了检索结果的时序一致性,在完全免训练的情况下展现出了极其强悍的跨数据集泛化能力。